Ein gutes Gespräch hat einen Rhythmus. Wir machen Pausen, wir unterbrechen, wir antworten, noch bevor der andere seinen Satz zu Ende gesprochen hat. Das passiert so selbstverständlich, dass wir kaum darüber nachdenken.
Am Telefon verhalten sich Menschen nicht immer so, wie man es erwartet. Sie fangen an zu antworten, bevor die Frage zu Ende ist, korrigieren sich mittendrin, bitten darum, etwas nachzuschauen, während sie weiterreden, oder sie werden frustriert und brauchen eine beruhigende Stimme.
Das alles in einen KI-Sprachagenten einzubauen, war unmöglich, bis jetzt.
Ab heute sind telli Duo Agenten öffentlich verfügbar: unsere neuen KI-Sprachagenten, die gleichzeitig zuhören und sprechen können.
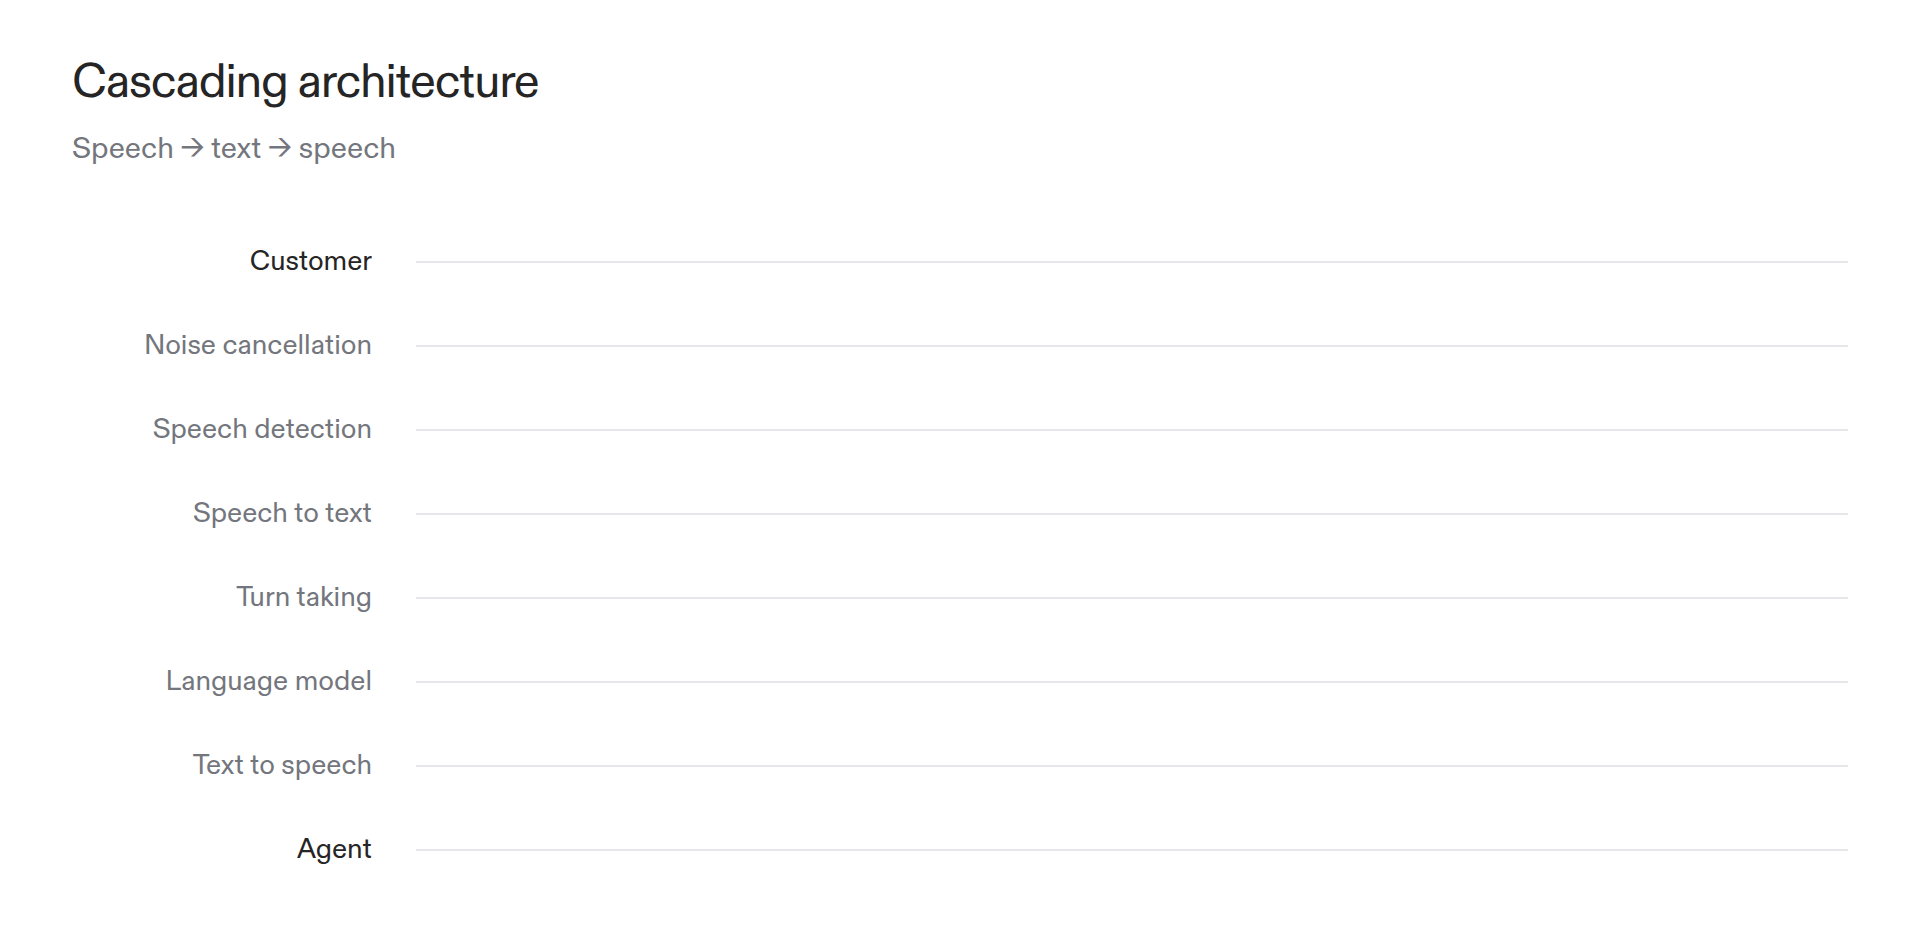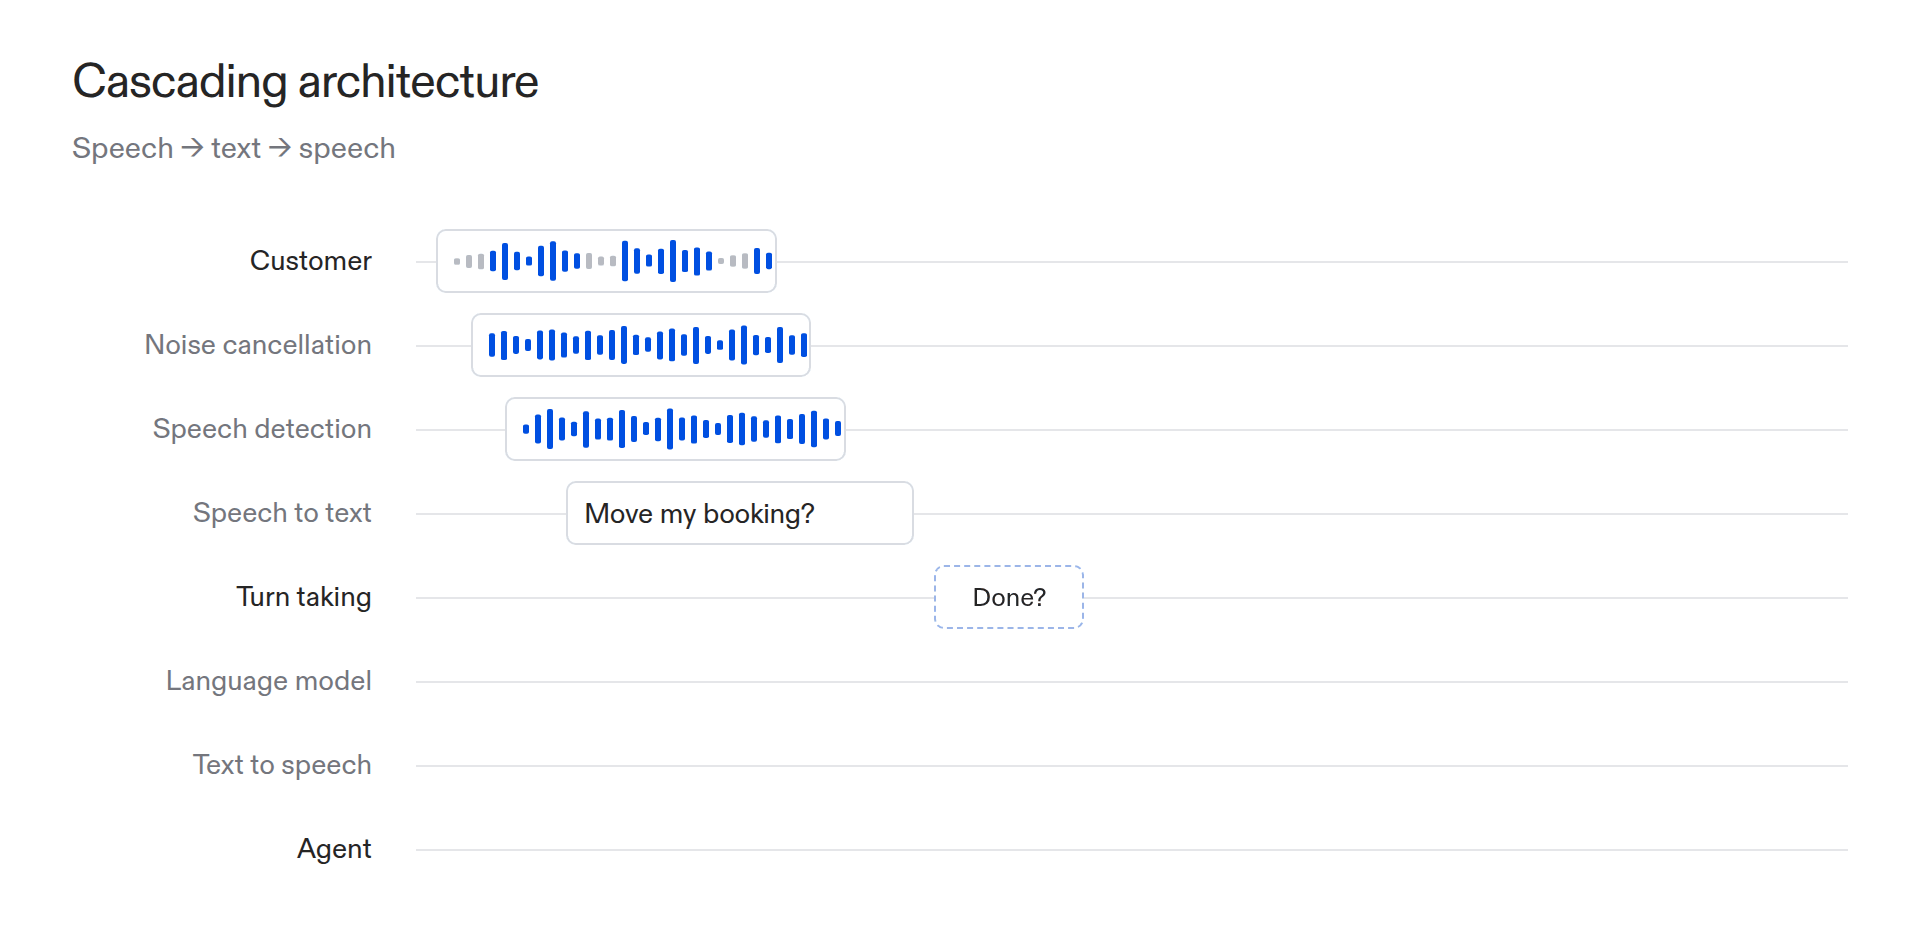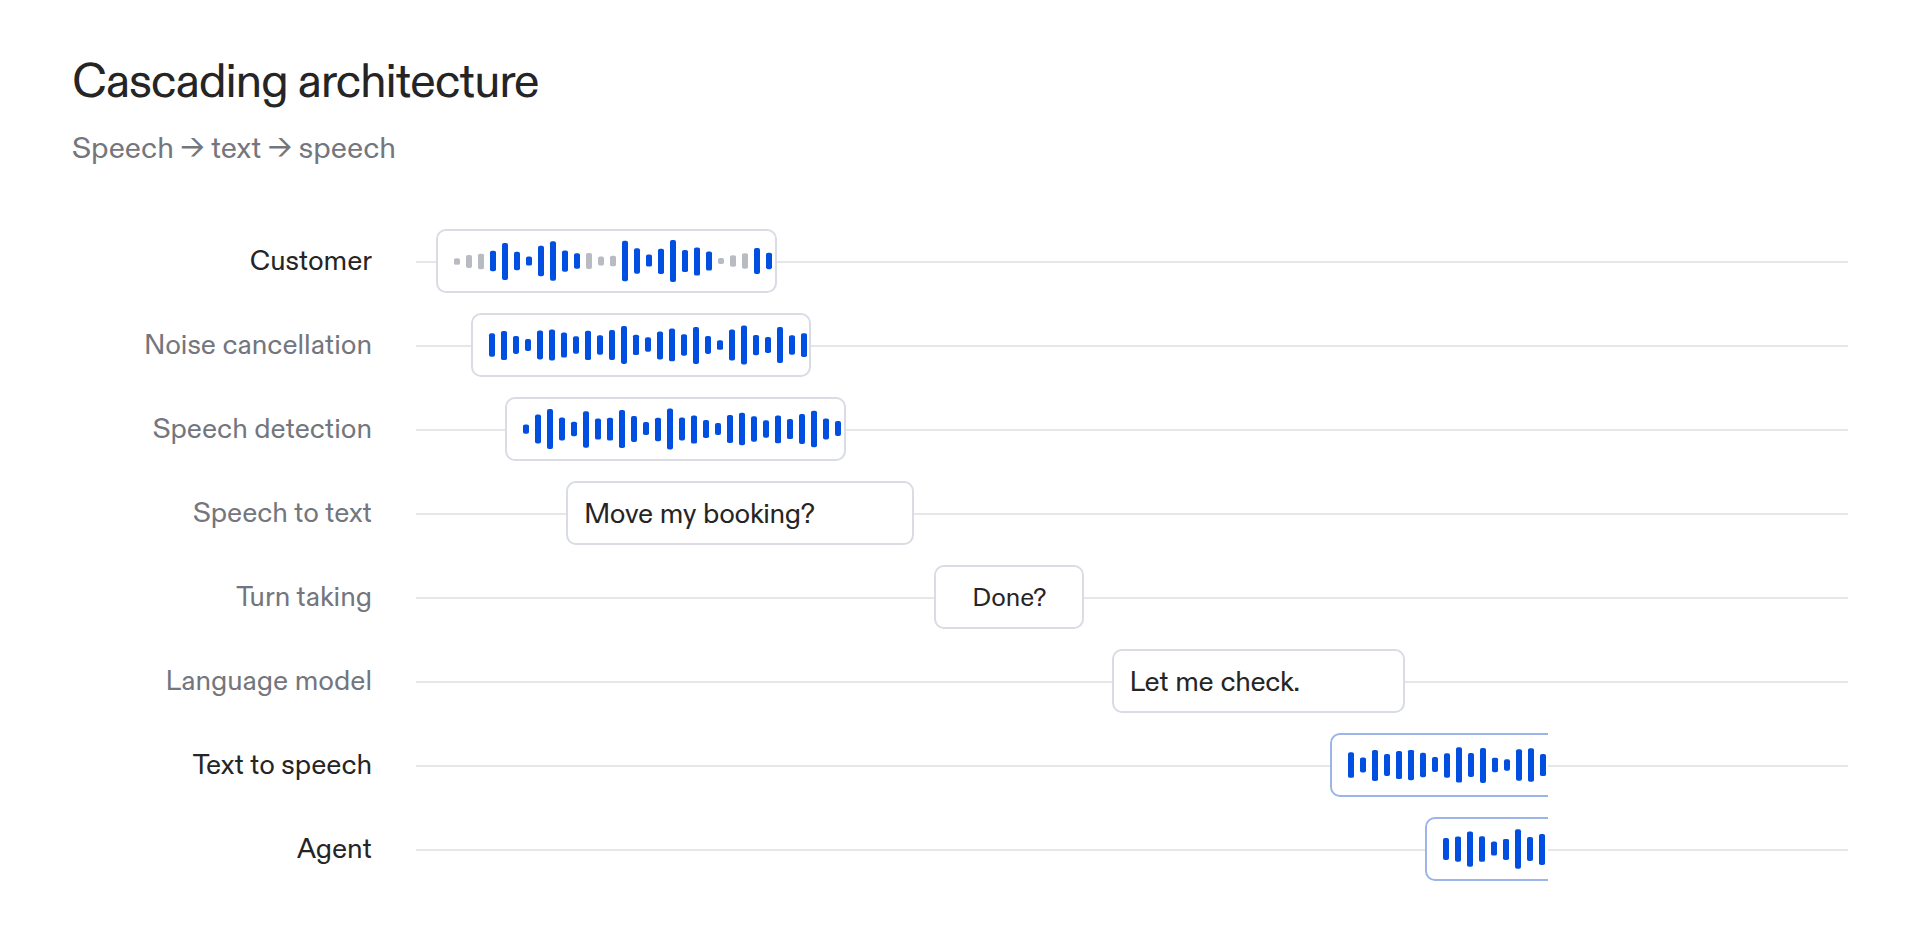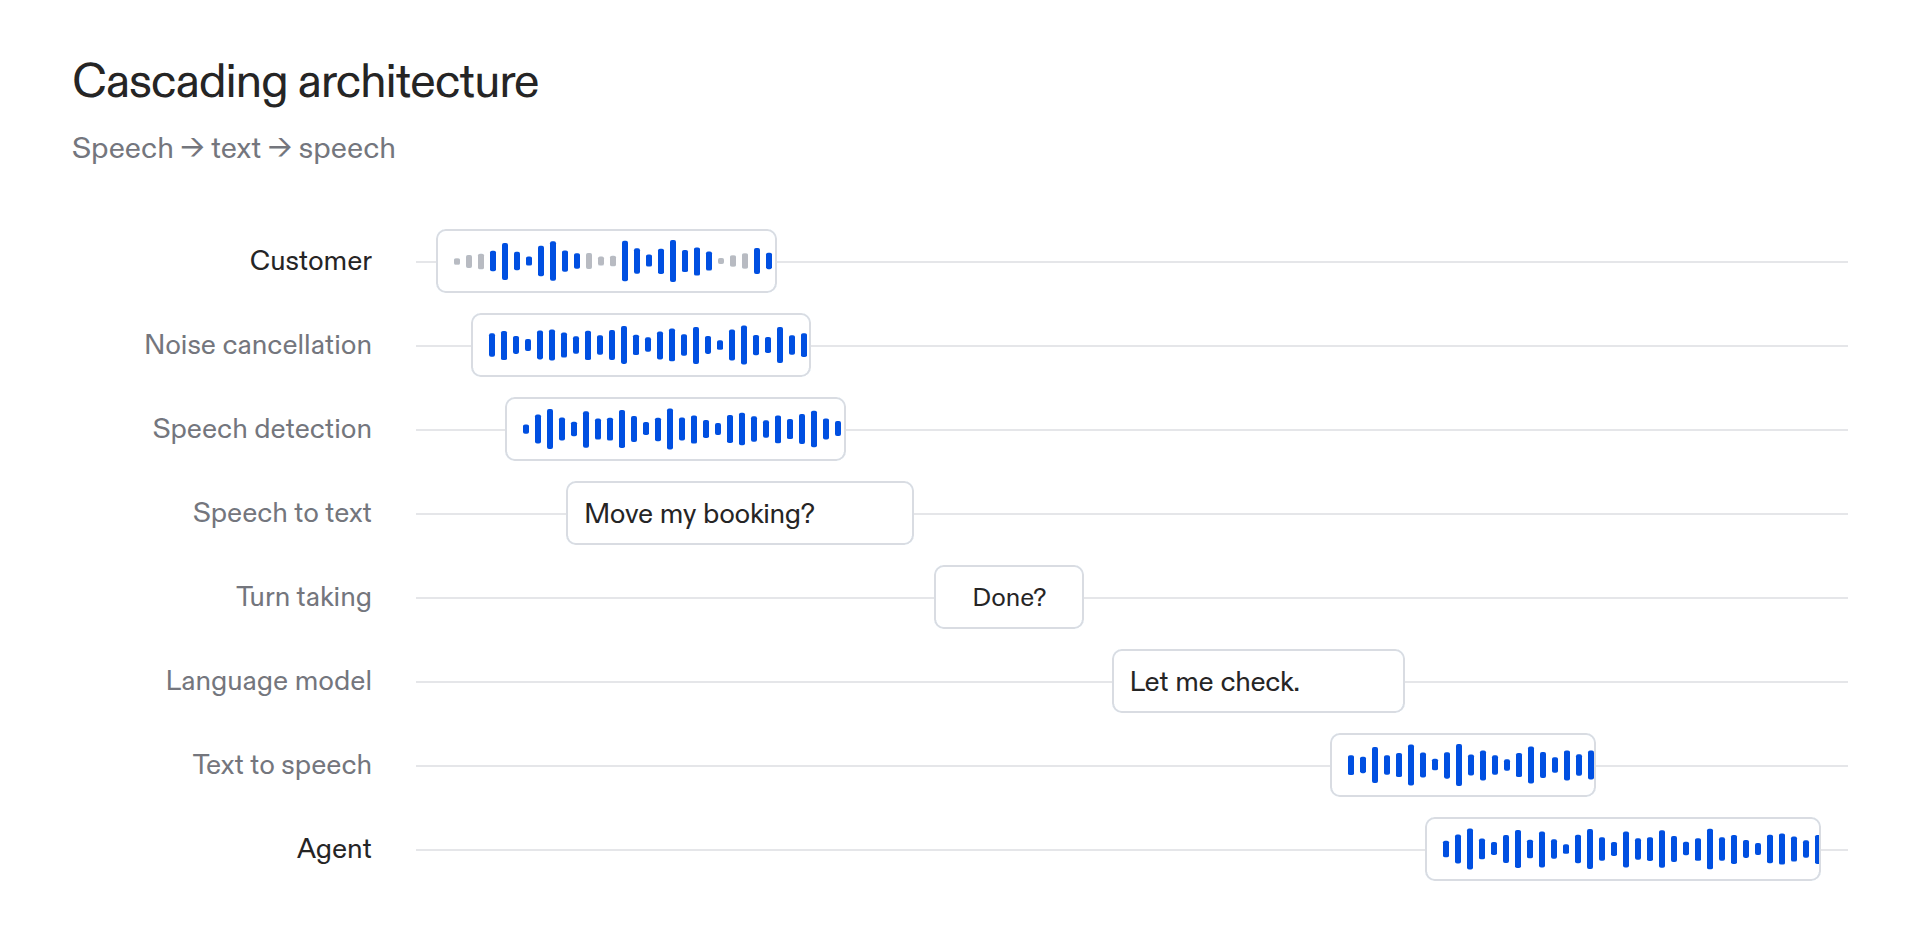
In den vergangenen zwei Jahren hat sich in der Branche die sogenannte „Cascading-Architektur“ durchgesetzt. Das heißt: Wenn ein Mensch mit einem Agenten spricht, wird das Gesprochene in Text transkribiert, in ein KI-Modell eingespeist und anschließend wieder in Sprache umgewandelt.
Diese Architektur hat einen grundlegenden Konstruktionsfehler: Ein Agent kann damit nicht gleichzeitig zuhören und sprechen. Stattdessen haben wir immer mehr Modelle zusammengestückelt, etwa Modelle zur Sprachaktivitätserkennung und zum Turn-Taking, um zu erraten, wann eine Person aufgehört hat zu sprechen und wann der Agent antworten soll. Aber egal, wie sehr wir uns bemüht haben, der Agent hat sich nie wirklich menschlich angefühlt.
Bei telli waren wir schon immer überzeugt, dass Speech-to-Speech-Modelle die Zukunft der Voice-KI sind. Nur ist jedes Modell, das wir getestet haben, genau daran gescheitert: Es hat Anweisungen nicht zuverlässig befolgt und ist an komplexen Stellen unvorhersehbar ausgestiegen.
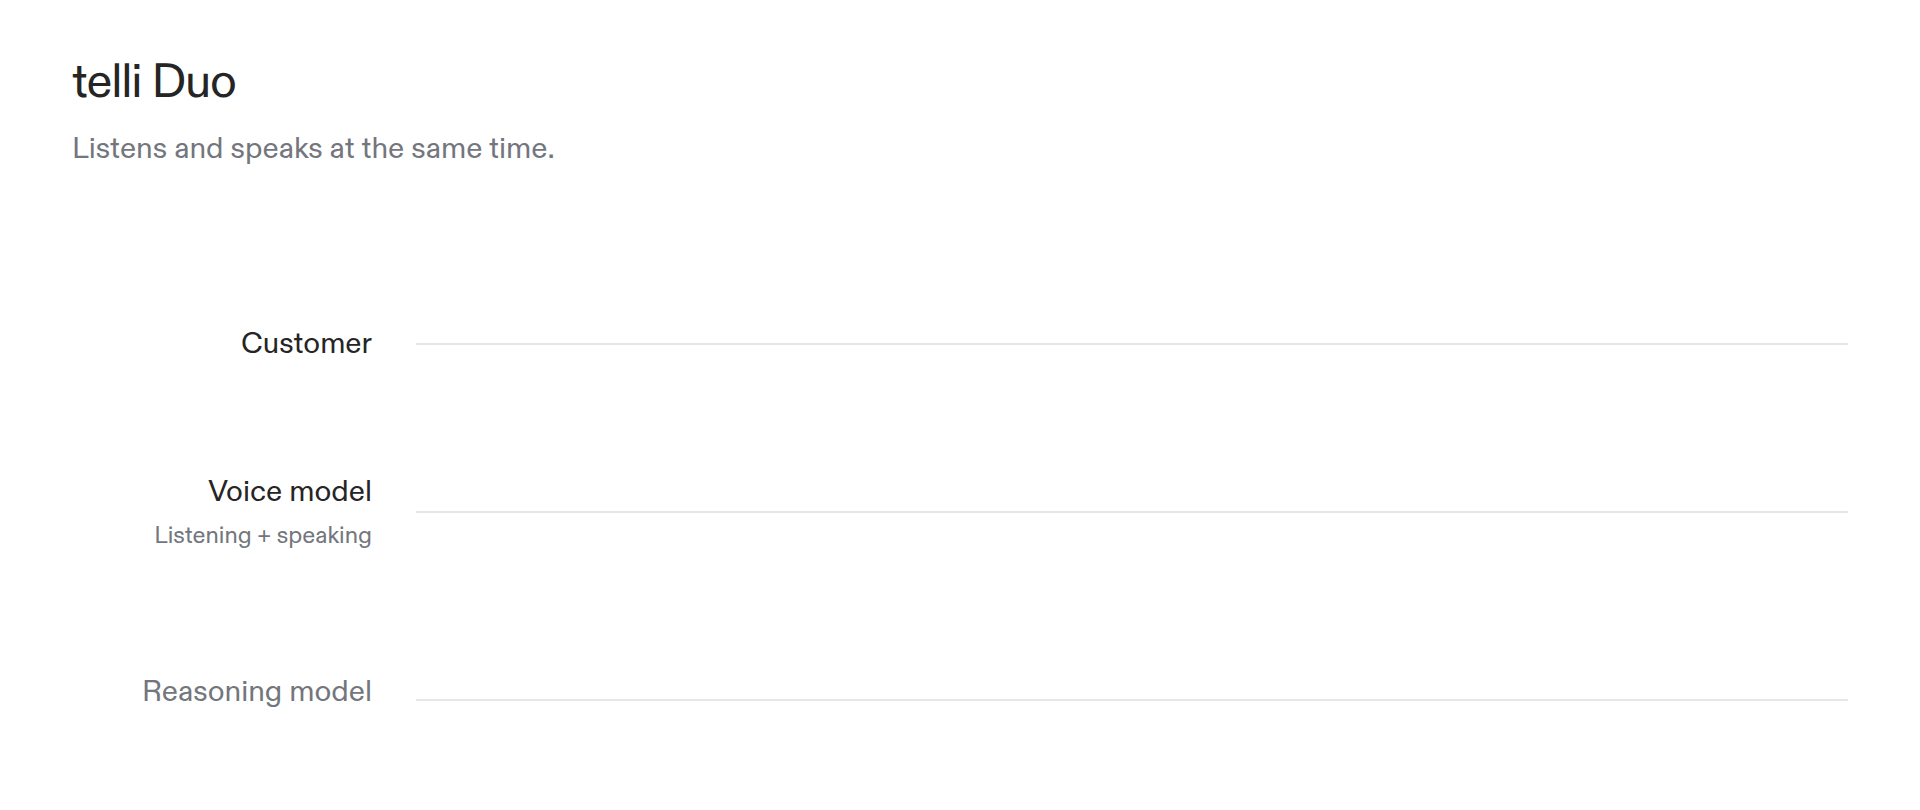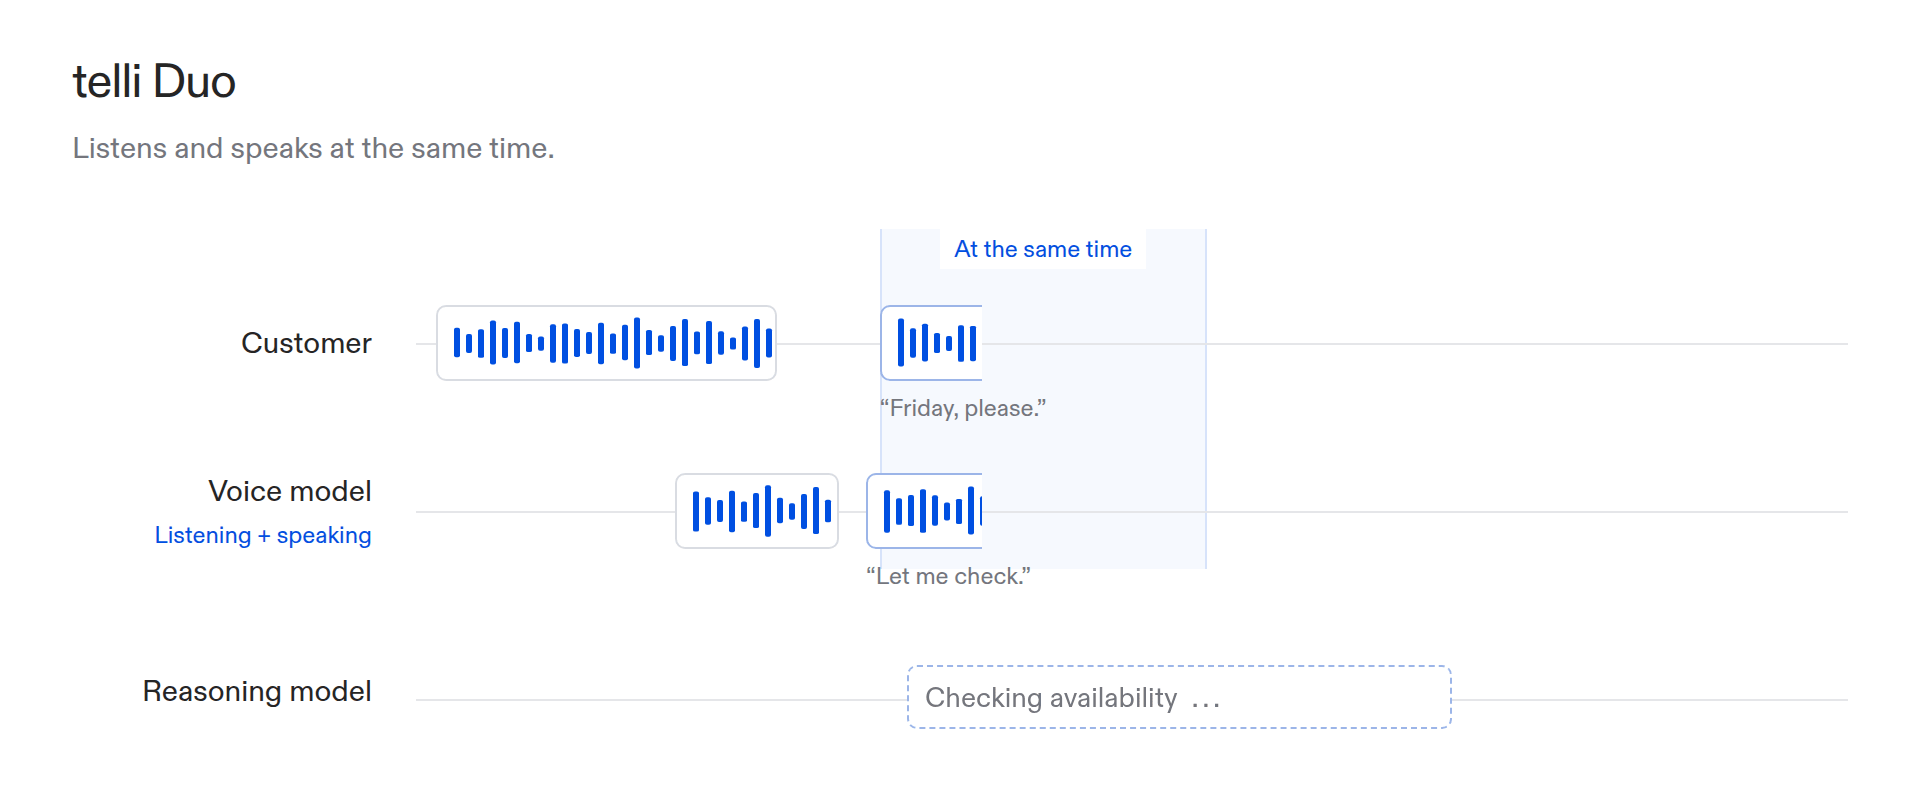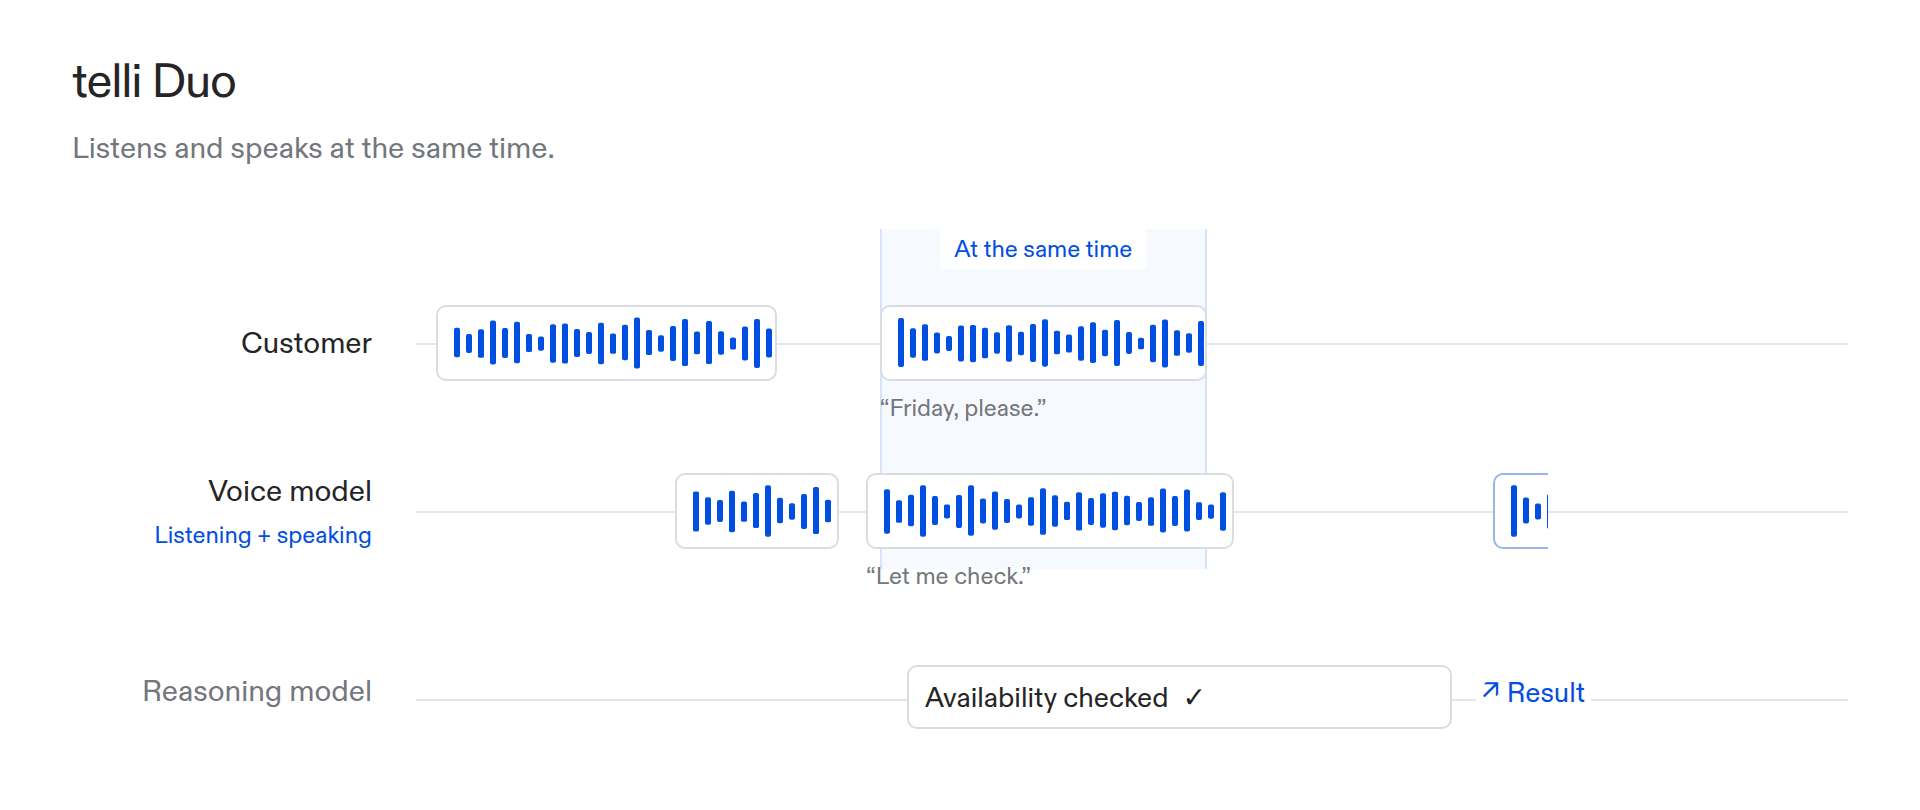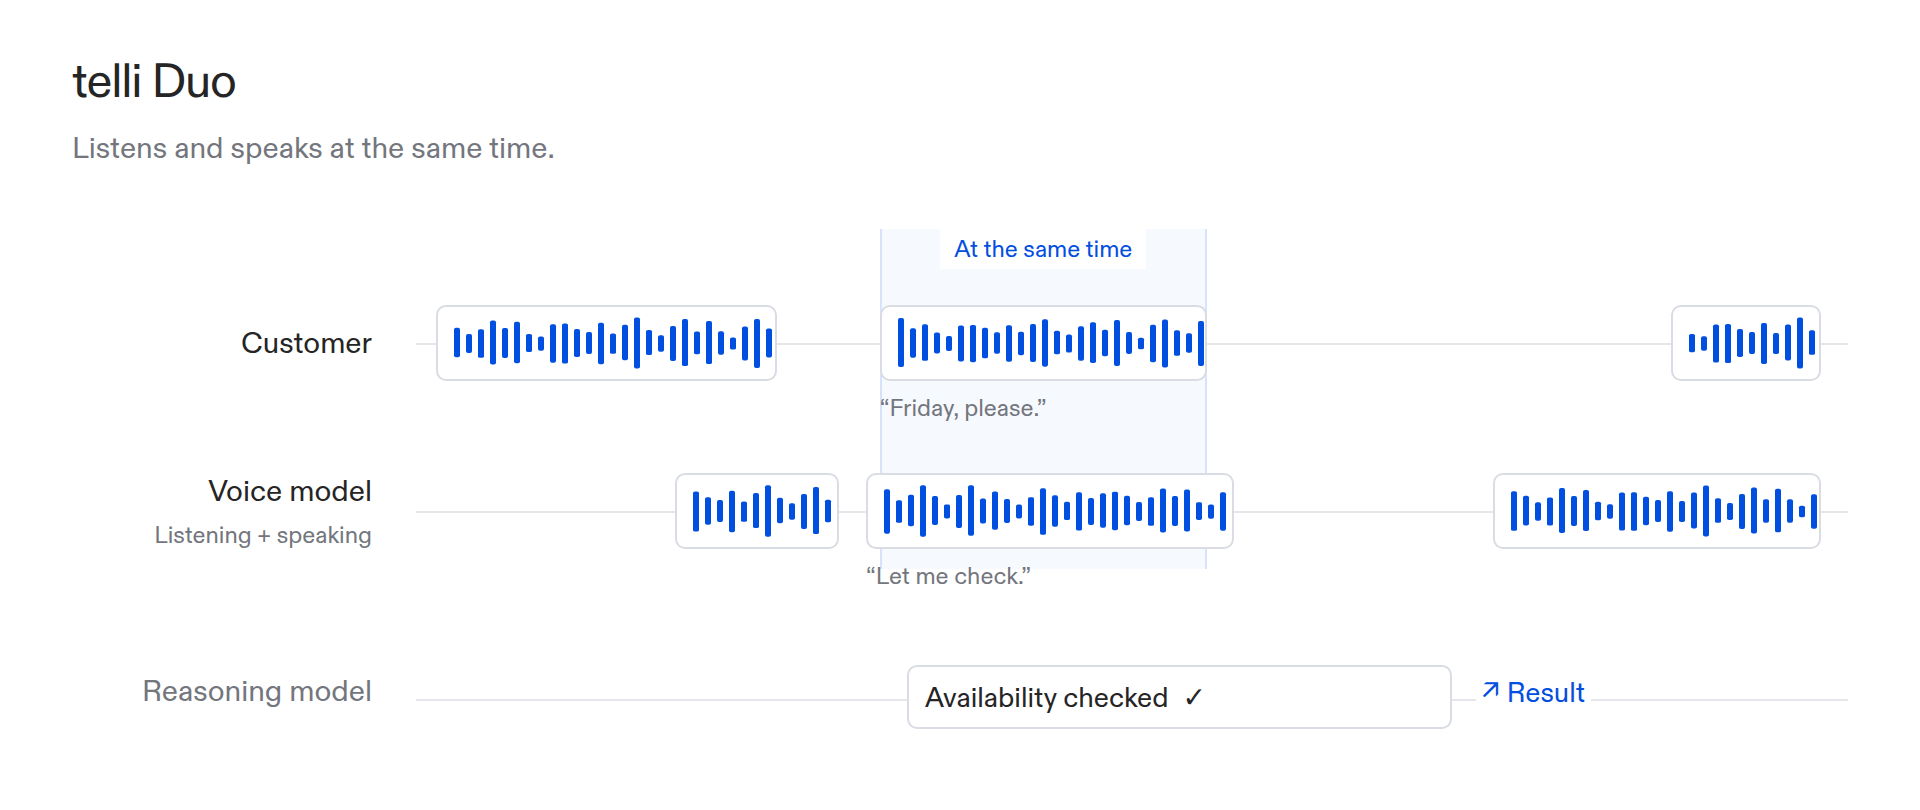
Das hat sich geändert, als wir vor ein paar Monaten frühen Zugang zu OpenAIs neuem Modell GPT-Live bekommen haben. Es ist ein Full-Duplex-Speech-to-Speech-Modell, das weiter zuhören kann, während es spricht. Es steuert Sprechfluss und Unterbrechungen direkt und lässt sich per Prompt anweisen, Aufgaben an ein anderes Modell abzugeben, wenn sie tieferes Reasoning erfordern.
Nach den ersten Benchmarks war schnell klar: Wir bauen unsere Voice-Infrastruktur rund um diesen Ansatz neu. Das war viel Arbeit und hat ein paar schlaflose Nächte gekostet, aber wir konnten auf zwei Jahre Erfahrung und Millionen von Anrufen im Produktivbetrieb zurückgreifen.
Das Ergebnis ist der neue telli Duo Agent. Zwei Modelle arbeiten Hand in Hand und schaffen so die beste Customer Experience bei Anrufen mit Voice-KI. Das eine Modell hört zu und spricht gleichzeitig mit der Person am Telefon. Das andere Modell übernimmt komplexe Aufgaben, die tieferes Nachdenken erfordern.
Damit es in jeder Umgebung und in jedem Use Case funktioniert, haben wir einen Routing-Mechanismus ergänzt, der weiß, wann er an intelligentere Modelle abgeben muss. Dazu haben wir unsere Voicemail-Erkennung, Warm Transfers, das Consent-Management und alle weiteren Funktionen eingebaut, die telli-Nutzer an unserer Plattform ohnehin schon schätzen.
Und weil das Prompting von Duo Agenten komplexer und vielschichtiger ist, haben wir Charlie, unseren KI-Kollegen, darauf trainiert, unseren Kunden dabei zu helfen, Duo Agenten ganz einfach zu bauen, ohne Angst haben zu müssen, dabei etwas kaputtzumachen.
Das erste Feedback unserer Kunden ist überwältigend. Bei vielen sind die KPIs sofort nach oben gegangen, und wir sind gespannt, welche neuen Use Cases sich auftun, wenn man endlich KI-Sprachagenten einsetzen kann, die sich wirklich menschlich anfühlen.
Bei telli sind wir überzeugt: Mit einem Unternehmen zu sprechen sollte so einfach sein wie ein Gespräch mit einem Freund. Duo bringt uns dieser Vision einen Schritt näher.
Probier es selbst auf telli.com aus oder buche eine Demo, dann zeigen wir dir, was telli Duo Agenten können.